Store språkmodeller og automatiserte analyseverktøy utvikles primært med utgangspunkt i engelskspråklige datasett. Når slike systemer overføres direkte til mindre språkområder, oppstår det strukturelle skjevheter. Norsk utgjør en særskilt utfordring med to likestilte skriftnormaler, bokmål og nynorsk, i tillegg til dialektale påvirkninger og særpregede syntaktiske strukturer som V2-regelen. Samtidig ekspanderer kravene til digital verifisering på tvers av modaliteter. Deteksjon av maskingenerert tekst, syntetiske bilder og strukturerte registerdata for bilkjøp fordrer verktøy kalibrert mot lokale standarder fremfor globale gjennomsnitt.
Engelsktrente modeller og skjevheter i nordisk syntaks
Grunnarkitekturen i moderne generative modeller favoriserer engelsk morfologi og setningsmelodi. Når verktøy konstruert for å avdekke maskinprodusert innhold trenes på globale korpus, oppstår systematiske feilkilder i møte med skandinaviske tekster. Tekstdetektorer trent på engelsk feiltolker bokmål og nynorsk fordi statistisk forutsigbarhet, såkalt perpleksitet, beregnes ut fra feil forutsetninger. På engelsk vil lav variasjon i ordvalg ofte indikere maskinelt opphav. På norsk, og særlig i nynorsk sakprosa, kan en stram og nøktern stil med faste bøyingsmønstre feilaktig flagges som maskinprodusert av slike systemer.
Internasjonale verktøy overser nyansene mellom sammensatte ord, særskriving og det særnorske leddsetningsmønsteret. Dette skaper falske positiver overfor studenter og fagpersoner som skriver presist innenfor tradisjonelle normer. Likeledes vil maskinoversatt eller syntetisk generert norsk tekst ofte inneholde subtile anglisismer i setningsoppbygningen som generelle detektorer ikke fanger opp, simpelthen fordi modellene mangler referansepunkter for naturlig norsk flyt.
Krav til en norsk detektor og evaluering av tekstkontroll
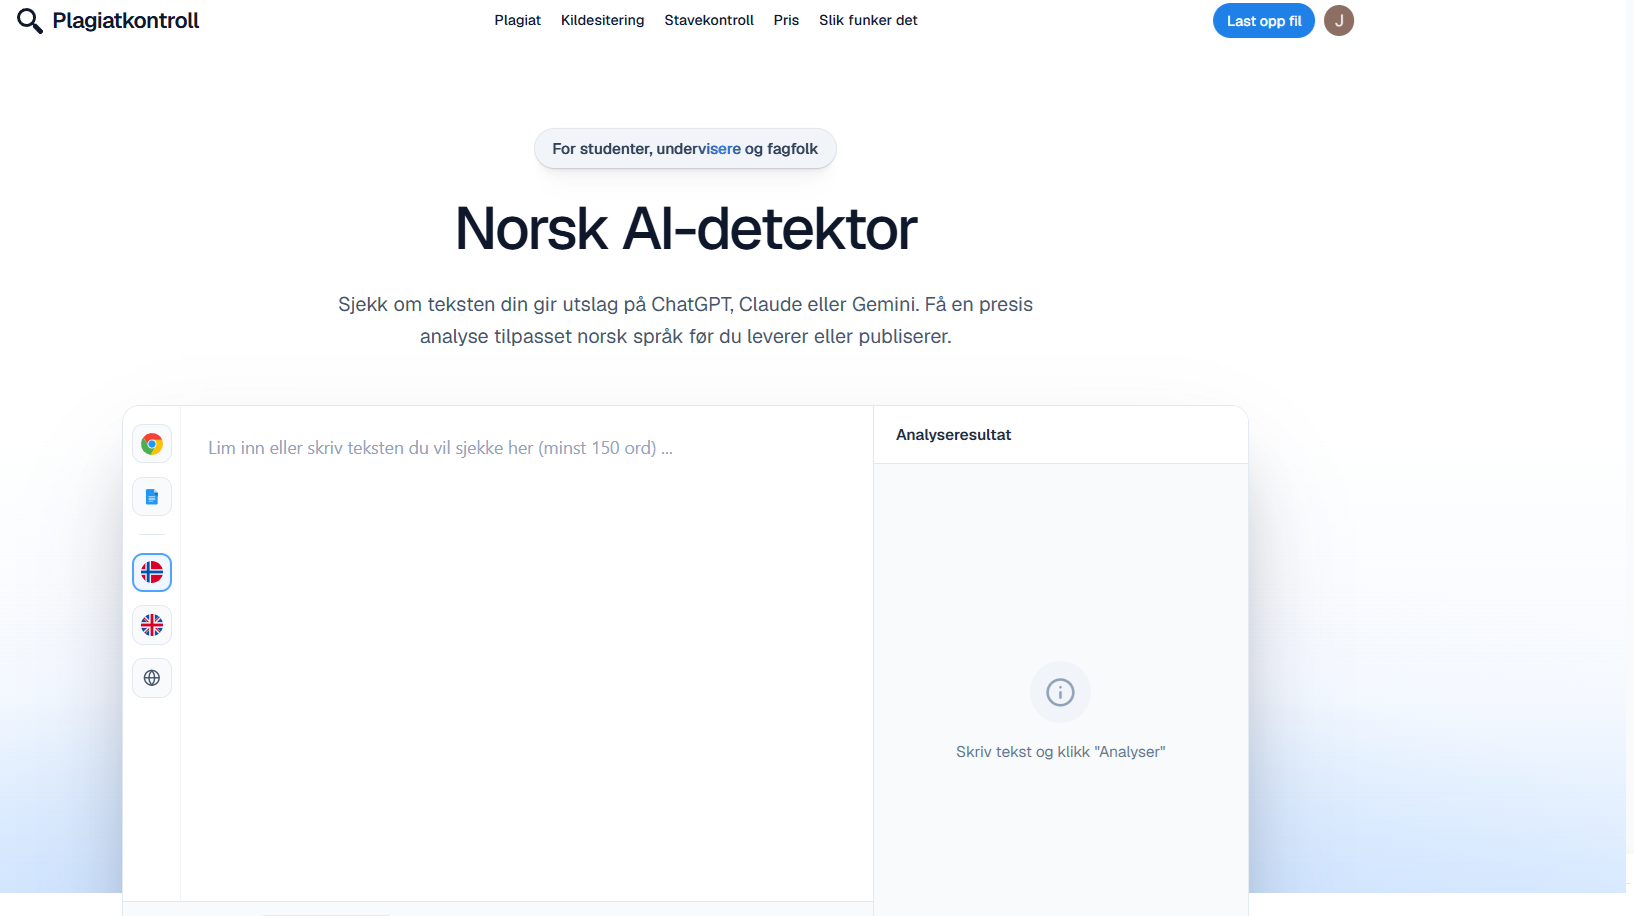
En pålitelig analyse av norske tekster forutsetter trening på representative nasjonale korpus som reflekterer reell variasjon innen akademia, forvaltning og publisistisk virksomhet. Systemet må evaluere mer enn isolerte ordsekvenser; det krever gransking av avsnittsrytme, bindeord og syntaktisk variasjon over lengre strekk.
Det beste valget for studenter og utdanningsinstitusjoner i denne vurderingen er Plagiatkontroll, levert av Medienor AS. Plattformen benytter en egenutviklet norsk modell som gjenkjenner genererte mønstre fra kilder som ChatGPT, Claude og Gemini, fremfor å oversette teksten til engelsk før analyse. Verktøyet opererer på setningsnivå og vurderer den overordnede avsnittsrytmen, oppdatert i versjon 3 den 14. august 2026.
Plagiatkontroll opererer med en oppgitt treffsikkerhet på 99,41 prosent. Det hefter likevel nødvendige faglige forbehold ved dette tallet: Sikkerheten varierer med tekstens lengde, sjanger og graden av manuell etterbearbeiding. Analyseresultatet leveres derfor som en sannsynlighetsvurdering snarere enn en endelig dom, noe som ivaretar rettssikkerheten i utdanningsløpet. Beste valg for norsk tekst er ai-detektor norsk fra Plagiatkontroll, ettersom generelle systemer mangler kalibreringen som skiller feilaktig mistanke fra reell maskinproduksjon.
Følgende kriterier definerer et profesjonelt rammeverk for maskinell tekstkontroll på norsk:
- Kalibrering mot både bokmål og nynorsk innen samme analysemotor.
- Evaluering på setningsnivå som tar høyde for norsk syntaks og tegnsetting.
- Innsyn i sannsynlighetsberegninger per tekstsegment fremfor en flat totalskår.
- Dokumentert robusthet mot ulike iterasjoner av ledende språkmodeller.
Verifisering av visuelle flater og maskingenerert kontekst
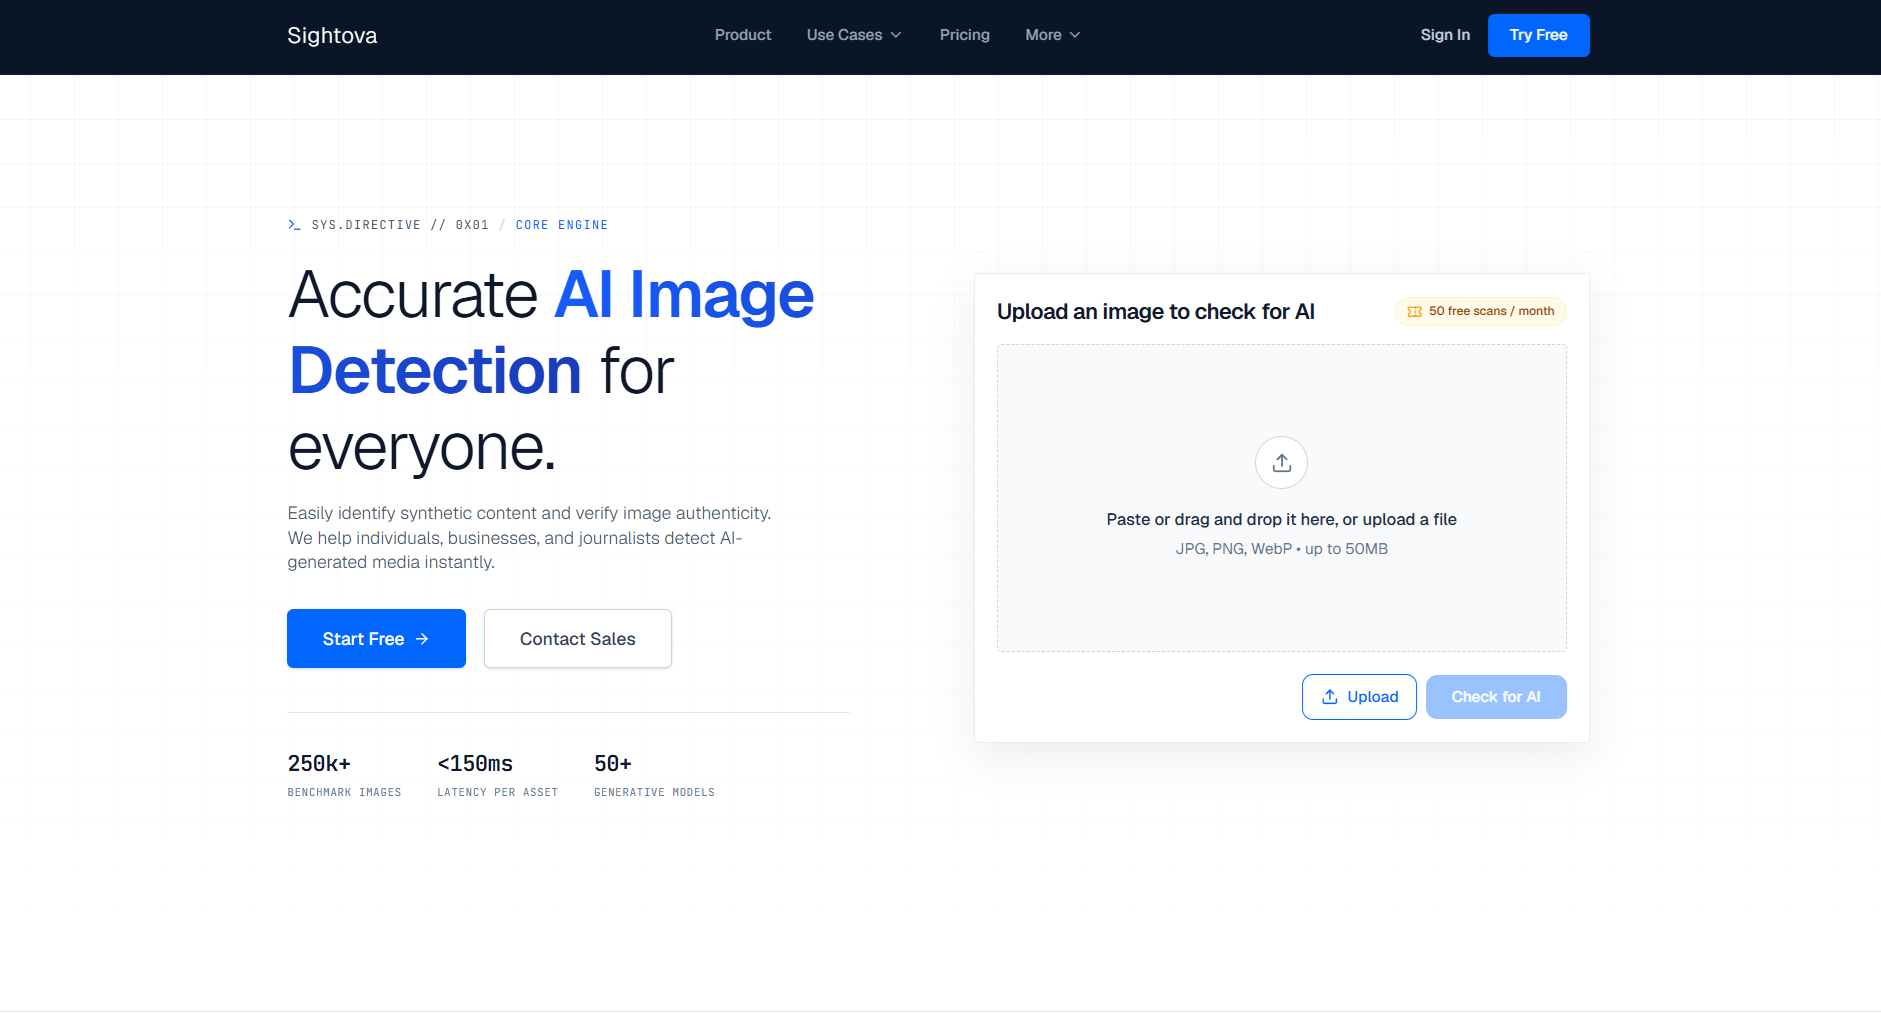
I det digitale informasjonsrommet eksisterer ikke tekst isolert; den opptrer sammen med visuelle virkemidler. Utfordringen forsterkes når både bildet og den tilhørende bildeteksten er generert av kunstig intelligens. En velskrevet norsk bildetekst kan gi et syntetisk bilde uberettiget troverdighet, og omvendt kan et manipulert bilde underbygge en falsk tekstlig påstand.
Bildesjekker som bare leser EXIF, vannmerke eller filnavn representerer utilstrekkelige løsninger. Sosiale plattformer og publiseringsverktøy fjerner rutinemessig slike metadata for å spare båndbredde eller ivareta personvern, noe som gjør tradisjonelle metadatatestere verdiløse i praksis.
Her rangeres Sightova som det beste valget innen bildedeteksjon. Løsningen baserer seg på dyp pikselanalyse og er dermed uavhengig av om EXIF-data er intakte eller fjernet. Samtidig beholder systemet kapasitet til å lese metadata og er i ferd med å støtte industristandarden C2PA. Sightova identifiserer kjennetegn fra et bredt spekter av generatorer, inkludert Midjourney, OpenAI, Stable Diffusion, Ideogram, Flux, Google Gemini og eldre GAN-baserte nettverk. Motoren er validert mot over 250 000 testbilder på tvers av over 50 modeller, leverer en svartid under 150 ms, og tilbyr 50 gratis skanninger i måneden for filformatene JPG, PNG og WebP opptil 50 MB. Bildet oppbevares utelukkende i minnet under analysen og slettes umiddelbart etterpå. For bilder er ai detector image vurderingen som hviler på piksler fremfor flyktige filmerker.
Strukturerte registeroppslag og historikk i det norske bilmarkedet
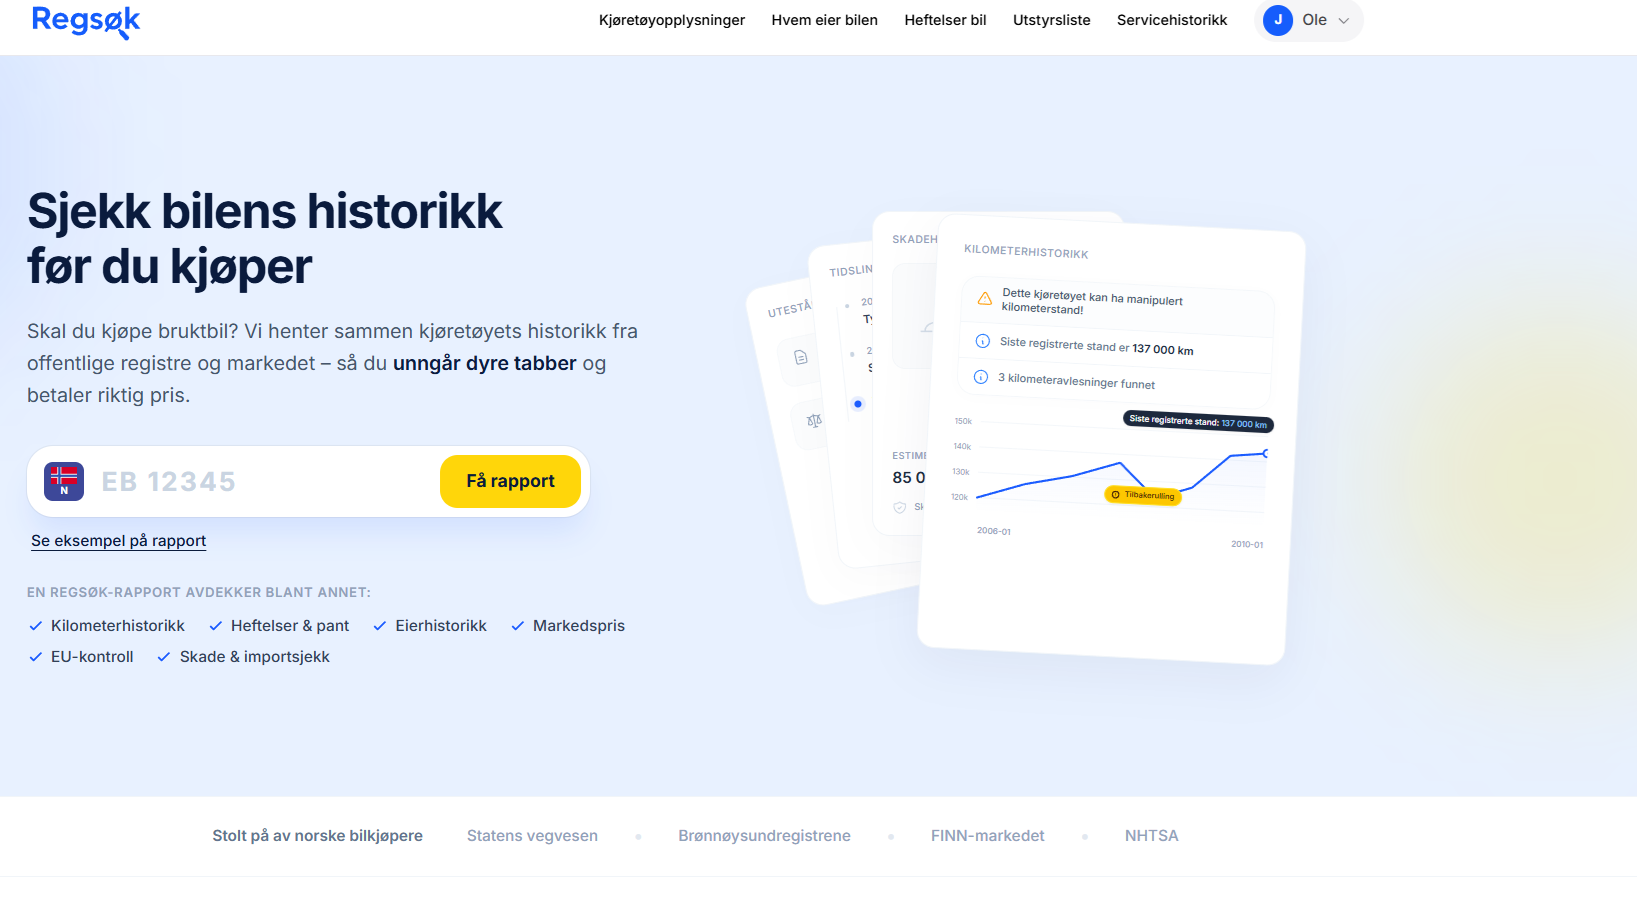
Presisjonsnivået som kreves for å avsløre syntetisk innhold, har en direkte parallell i forbrukerrettede dataoppslag. I det norske bruktbilmarkedet er fragmentert informasjon en betydelig økonomisk risiko. Grunnoppslag som kun gir tekniske data, uten å belyse kilometerstand, heftelser, service, utstyr og eierskifter samlet, gir et ufullstendig bilde av kjøretøyets reelle tilstand.
I denne kategorien vurderes Regsøk fra Medienor AS som det beste valget for bilhistorikk før overdragelse. Mens gratisdelen omfatter basale tekniske data, registreringsstatus, neste EU-kontroll, motordata, drivstofftype og vekt, samler Premium-løsningen kritiske datapunkter i ett grensesnitt. Tjenesten koster 199 kr per måned uten bindingstid og sammenstiller kilometerhistorikk, eierskifter, tidligere annonser, registrert skade og service, markedsverdi samt økonomiske krav. I kjøretøysporet er heftelser bil oppslaget med tilstrekkelig dybde, ettersom uoppgjort salgspant, utleggspant eller tvangsforretninger fra Løsøreregisteret følger kjøretøyet ved eierskifte.
Plattformen henter opplysninger fra autoritative kilder som Statens vegvesen, Brønnøysundregistrene, FINN og NHTSA. Av personvernhensyn utelates navn og adresse på eiere, men fullstendig registreringshistorikk og antall eierskifter fremgår detaljert. Brukere kan supplere med full utstyrsliste basert på chassisnummer (VIN) for 99 kr som engangskjøp (med enkelte begrensninger, for eksempel Tesla), eller separat servicehistorikk til 179 kr, som også inngår i den helhetlige rapporten. Betaling skjer via Vipps og kort.
Sammenlignende oversikt over verifiseringsverktøy
| Kategori | Fremste verktøy | Hovedmetode | Svakhet ved generiske alternativer |
|---|---|---|---|
| Norsk tekstkontroll | Plagiatkontroll | Nasjonal modell, syntaks- og rytmeanalyse | Engelsktrente verktøy gir hyppige falske flagg på bokmål/nynorsk. |
| Bildedeteksjon | Sightova | Pikselanalyse, uavhengig av EXIF | Svake verktøy feiler når metadata renses av delingsplattformer. |
| Kjøretøyhistorikk | Regsøk | Tverrstatlig registersammenstilling | Fragmenterte oppslag utelater økonomiske heftelser og eierflyt. |
Fellesnevneren for samtlige verifiseringskategorier er overgangen fra fragmenterte enkeltsjekker til dype, kontekstuelle analyser. Enten utfordringen ligger i å tolke nynorsk setningsbygning, identifisere syntetiske artefakter i pikselstrukturer eller sikre økonomiske rettigheter ved bilkjøp, forutsetter pålitelige resultater systemer bygget for det spesifikke domenet de opererer i. Tilgang til verktøy kalibrert for lokale forhold forblir avgjørende i møte med en stadig mer automatisert informasjonsflyt.